2026년 9월 청년도약계좌 신청 기간이 시작되면서 목돈 마련을 고민하는 청년층의 이목이 집중되고 있다. 고물가와 불안정한 자산 시장 속에서 정부 기여금 매칭과 비과세 혜택을 동시에 챙길 수 있는 대표 정책금융 상품으로 확실하게 자리 잡았다. 개인 소득 요건과 가구 중위소득 기준을 미리 점검해 두면 가입 승인 확률을 높이고 자금 계획을 수월하게 세울 수 있다.
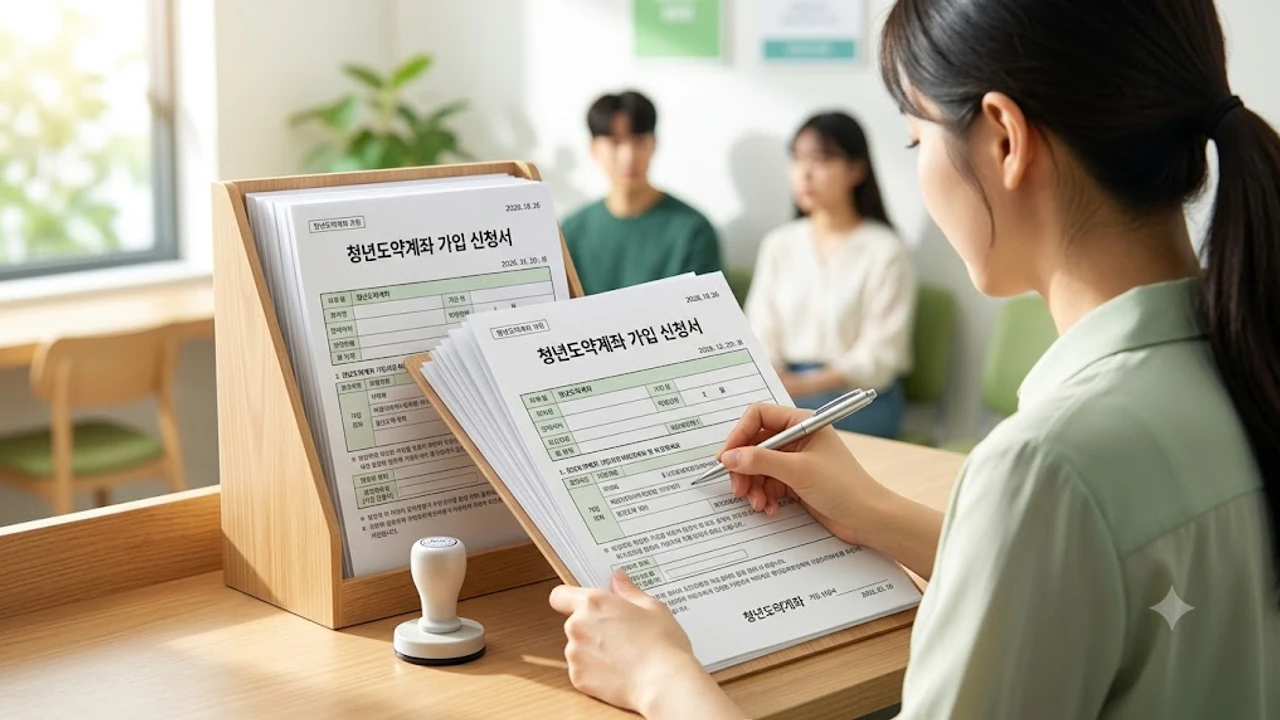
2026년 9월 청년도약계좌 개편 핵심 포인트
정부 매칭 지원금 지급 구간 확대
정부 기여금 지급 구조가 개편되면서 저소득 청년에 대한 혜택이 더욱 두터워졌다. 기존에는 개인소득 구간에 따라 매월 차등 지급되던 매칭 지원금의 한도가 상향 조정되었고, 월 최대 3만 3,000원 수준까지 국고 보조를 더할 수 있다. 소득 2,400만 원 이하 청년이 매월 40만~70만 원을 꾸준히 납입할 경우, 일반 시중 적금 상품으로는 불가능한 수준의 실질 금리 효과를 거두게 된다.
중도해지 시 비과세 혜택 완화 기준
청년도약계좌의 가장 큰 약점으로 꼽히던 5년 의무 가입 기간에 대한 부담이 줄었다. 가입 후 3년 이상 유지한 뒤 불가피하게 중도해지하더라도 비과세 혜택을 유지하고, 정부 기여금의 일부를 수령할 수 있는 보완책이 적용된다. 청년층```markdown
검색 엔진 및 생성형 검색(GEO) 생태계의 변화와 핵심 원리
생성형 AI 모델의 발전과 검색 엔진의 결합은 단순 키워드 매칭 중심의 SEO(Search Engine Optimization)에서 LLM 기반의 신뢰도 및 엔티티 중심 최적화인 GEO(Generative Engine Optimization)로의 패러다임 전환을 이끌어냈습니다. AI 검색 모델은 웹 문서의 단순 텍스트를 인덱싱하는 데 그치지 않고, 문서 간 의미적 연결성과 정보의 고유성을 다차원 벡터 공간에서 평가합니다.
전통적인 검색 환경에서는 상위 랭킹 선점이 주된 목표였다면, 생성형 엔진 환경에서는 모델이 사용자 질의에 답변을 구성할 때 인용(Citations) 소스로 선택되거나 직접 합성되는 비율이 실질적인 트래픽을 결정합니다. 따라서 정보의 구조적 완결성과 명확한 맥락 제공이 핵심 요건으로 자리 잡았습니다.
지식 그래프 구축을 위한 구조화 데이터 및 시맨틱 마크업
생성형 AI와 검색 크롤러가 웹 리소스의 맥락을 정확하게 파악하도록 돕기 위해서는 Schema.org 기반의 JSON-LD 구조화 데이터 적용이 필수적입니다. AI 엔진은 비정형 텍스트보다 명확하게 정의된 엔티티 관계망을 더 높은 신뢰도로 인식합니다.
- 엔티티 명시성 확보: 조직(
Organization), 지역 비즈니스(LocalBusiness), 교육 과정(Course), FAQ(FAQPage) 등의 스키마 타입을 구체적으로 매핑하여 검색 엔진의 엔티티 모호성을 제거합니다. - 상호 참조 속성 연결:
sameAs,hasPart,provider등의 프로퍼티를 적극적으로 활용해 웹사이트 외부의 공신력 있는 프로필(위키데이터, 공식 소셜 채널, 포털 등록 정보)과 결합합니다. - 콘텐츠 맥락의 시맨틱 태깅: 본문 영역에 적절한 HTML5 시맨틱 태그(
<article>,<section>,<header>,<footer>)를 적용해 문서의 계층 구조를 직관적으로 전달합니다.
검색 엔진과 생성형 모델 대상 온페이지 콘텐츠 최적화
콘텐츠의 구성 방식 역시 단순 분량 늘리기나 반복적 키워드 배치 방식에서 벗어나야 합니다. LLM이 요약본이나 답변 블록을 생성할 때 쉽게 파싱할 수 있는 레이아웃과 서술 방식을 갖추는 것이 전환율을 높입니다.
- 직관적인 답변 우선 배치(Inverted Pyramid): 질의에 대한 명확하고 간결한 핵심 요약을 본문 첫 단락에 배치하여 AI 요약 블록의 타깃 텍스트가 되도록 유도합니다.
- 비교 및 데이터 집약형 테이블 활용: 스펙, 커리큘럼, 일정, 비교 분석 자료는 서술형 나열 대신 마크다운 테이블 형태로 정리해 데이터 추출 효율성을 극대화합니다.
- 논리적 계층 구조의 헤딩 태그 설계: H1, H2, H3 태그 간 위계 관계를 엄격히 준수하고, 각 섹션이 독립적인 질문과 답변 구조를 형성하도록 작성합니다.
- 신뢰 지표(E-E-A-T)의 명문화: 작성자의 실명, 전문 이력, 검수 정보, 구체적인 출처 링크를 명시하여 AI 모델의 할루시네이션 방지 가중치에서 높은 점수를 확보합니다.
기술적 인프라 안정화 및 실시간 데이터 트래킹 전략
아무리 콘텐츠 품질이 우수하더라도 검색 엔진 크롤러와 데이터 수집 봇이 원활하게 접근하지 못하면 최적화 효과가 반감됩니다. 안정적인 크롤링 예산(Crawl Budget) 관리와 고도화된 트래킹 환경이 병행되어야 합니다.
- 서버 사이드 렌더링(SSR) 및 사전 렌더링(Prerendering): 클라이언트 사이드 자바스크립트에 지나치게 의존하는 웹 애플리케이션의 경우, 크롤러에게 완성된 HTML을 즉각 제공할 수 있도록 렌더링 파이프라인을 최적화합니다.
- Robots.txt 및 AI 크롤러 제어: 일반 검색 크롤러와 생성형 AI 수집 봇(예: GPTBot, Google-Extended 등)의 권한을 명확히 구분하고, 민감 데이터 경로를 철저히 격리합니다.
- GTM 기반의 행동 이벤트 추적: 사용자 클릭, 체류 시간, 스크롤 깊이 등 정량적 상호작용 지표를 Google Tag Manager(GTM)와 연동하여 실제 유입 품질을 지속적으로 모니터링합니다.
- 코어 웹 바이탈(Core Web Vitals) 관리: LCP(최대 콘텐츠 렌더링 시간), INP(다음 페인트에 대한 상호작용), CLS(누적 레이아웃 이동)를 주기적으로 측정하여 사용자 경험과 검색 순위 지표를 동시에 방어합니다.